スキャン PDF をテキストに
取り出そう、スキャン PDF
スキャンでできた PDF をアップロードすると、全ページのテキストが手に入ります。
ここにページかフォルダをドロップ
すべてのページを追加できます。元の画像はすべて保存され、フォルダや大量のファイルはバッチ整理画面で開きます。
ページの比較 · 処理前と処理後
元のページと比較。
テキストを活用。
元のページと Inksight の実際の文字起こしを比較できます。利用や書き出しの前に、名前、日付、数字、空欄を確認してください。
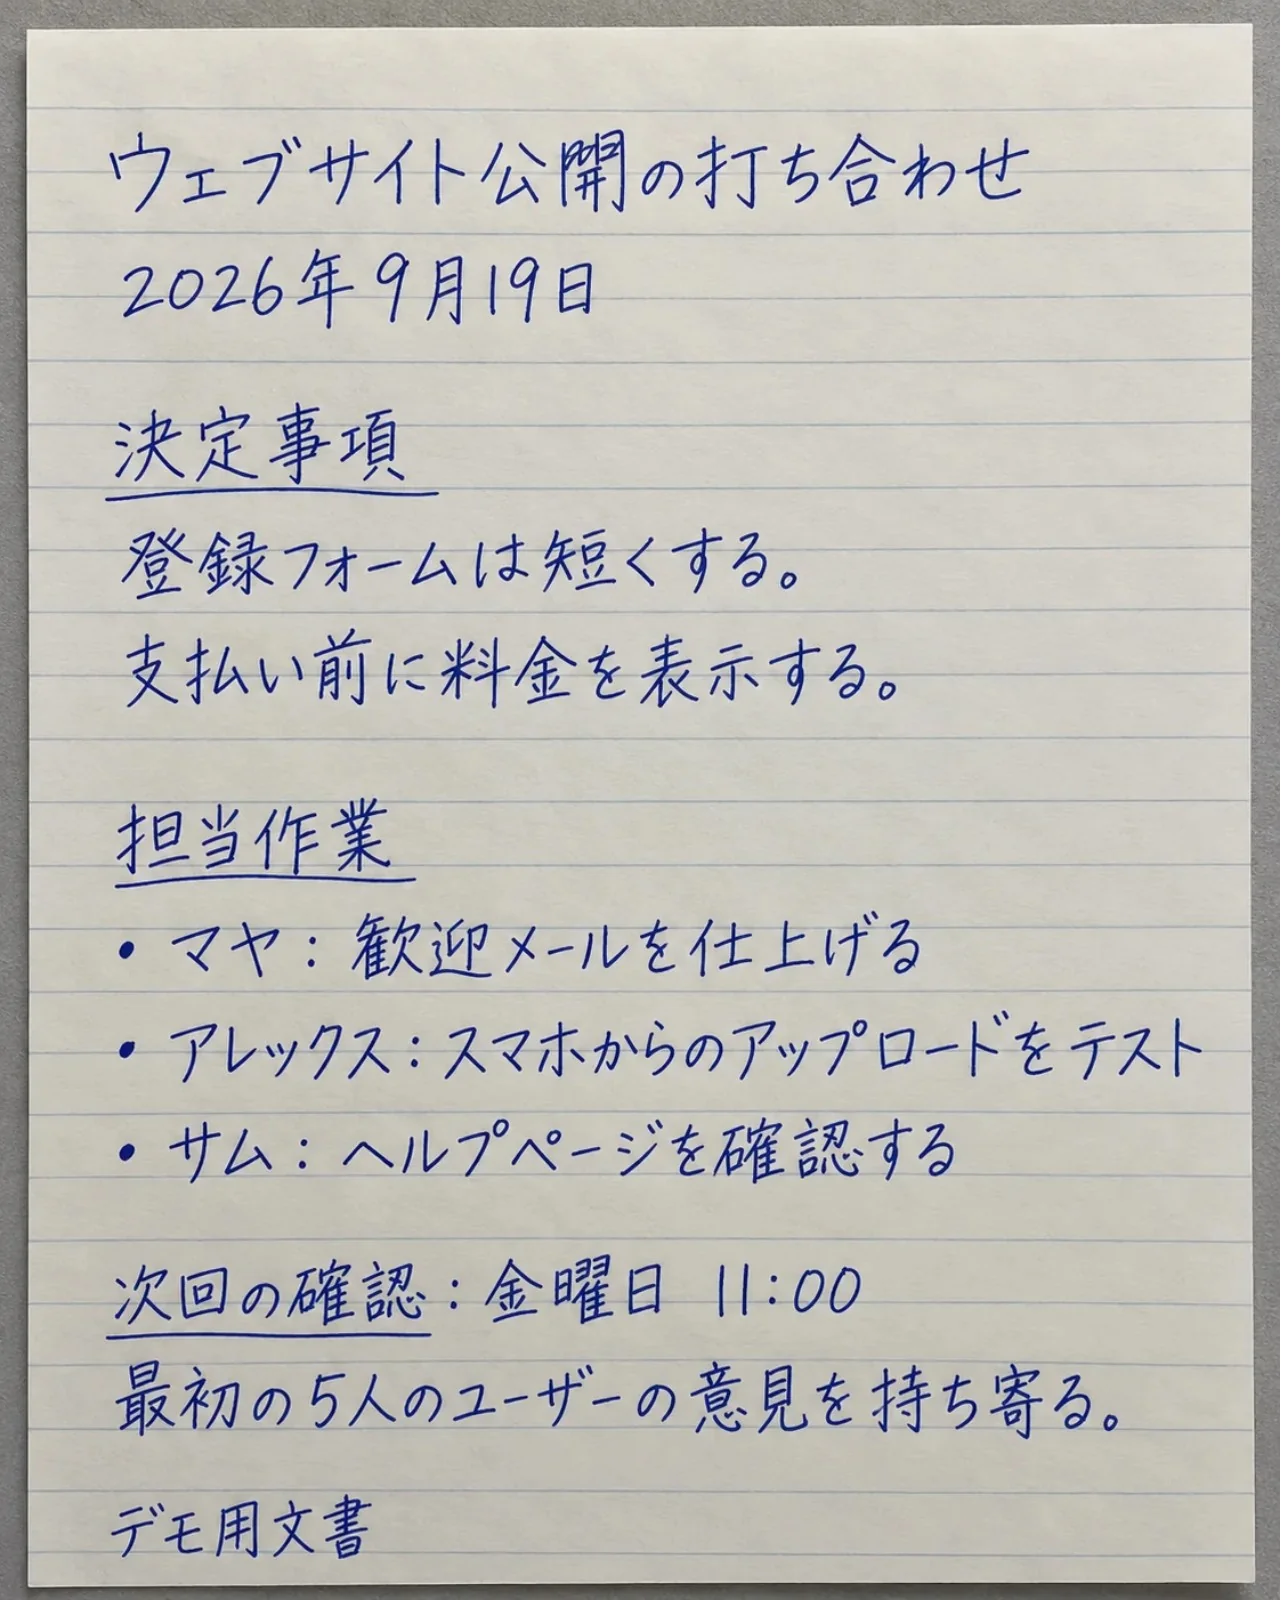
ウェブサイト公開の打ち合わせ 2026年9月19日
決定事項 登録フォームは短くする。 支払い前に料金を表示する。
担当作業 ・マヤ:歓迎メールを仕上げる ・アレックス:スマホからのアップロードをテスト ・サム:ヘルプページを確認する
次回の確認:金曜日 11:00 最初の5人のユーザーの意見を持ち寄る。
デモ用文書
生物の復習
細胞膜
構造
リン脂質二重層が細胞を包んでいる。
タンパク質は物質が膜を通過するのを助ける。
物質の輸送
拡散:粒子は濃度勾配に従って移動する。
浸透:水は半透膜を通って移動する。
能動輸送にはエネルギーが必要。
覚えること
拡散と能動輸送を比較する。
表面積が重要な理由を説明する。
デモ用文書
AI が生成したデモページを Inksight で読み取りました。表示テキストは手作業で修正していません。結果は画像とレイアウトによって異なります。名前、数字、合計を確認してください。
自分の文書を試すGoogle Play で5点満点中4.7。
評価スコアは2026年10月16日に確認 · 評価135件とレビュー本文32件は2026年8月30日に集計
本番環境で読み取りが完了した OCR ページは約202,000ページ · 本番セッションを記録した国は160か国 · 利用状況は2026年11月15日時点. この数値の算出方法
言葉はそこにある。まだテキストになっていないだけ。
スキャンした PDF はページの画像を収めたものなので、検索してもコピーしても何も見つかりません。Inksight は全ページを読み取り、編集して保存できるテキストにします。
スキャンした PDF
コピー機、スキャンアプリ、資料館から届く、全ページが画像のファイル。
印刷と手書きが混在
印刷された項目名に手書きで記入したフォームや、余白に書き込みのある印刷ページ。
長いファイル
ページ数の多い PDF も1ページずつ読み取り、1つの文書として保存します。
ドキュメントとして仕上がる OCR。
結果を確認している間も、原本は表示されたままです。ページが正しく読み取れたと分かる前に、ダウンロードの向こう側へ隠されるものはありません。
| できること | Inksight | 一般的な OCR |
|---|---|---|
| 画像でできた PDF | 全ページを読み取る | 検索もコピーも何も見つからない |
| PDF 内の手書き | 印刷文字と一緒に読み取る | たいてい飛ばされる |
| 保存前の修正 | 各ページをスキャンの横で編集 | 先に保存して、後から修正 |
| ファイル形式 | Word・検索できる PDF・Excel・テキスト | プレーンテキスト |
50以上の言語に対応した手書き認識。
英語・スペイン語・フランス語・ポルトガル語などのラテン文字のメモに加えて、アラビア語、ヘブライ語、ヒンディー語、ベンガル語、タミル語、中国語、日本語、韓国語など、対応する文字体系を読み取れます。言語はページから自動で判定するため、事前に設定する項目はありません。
認識の精度は、筆跡、画像の鮮明さ、ページの角度、書類の構造によって変わります。書き出しを使う前に、重要な氏名や数値はご確認ください。
ページをスキャンする前に。
PDF のテキストが選択できないのはなぜですか?
ページが画像だからです。スキャンや写真を PDF として保存したものにはテキストが含まれていないため、ページを読み取るまで検索もコピーもできません。
PDF から手書きのテキストを取り出すには?
ここに PDF をアップロードしてください。1ページずつ読み取り、ページの画像の横にテキストを表示します。間違いを直してから保存できます。
検索できる PDF は作れますか?
はい。ダウンロードする PDF はスキャン画像ではなくテキストから作るため、検索もコピーもできます。Word・Excel・テキストも同じページから作成できます。
何ページまでアップロードできますか?
ページ数の多い PDF でも問題ありません。ウェブでは最初の10ページが無料です。それ以降のページも読み取ったうえで、プランを選ぶまではロックされたプレビューとして表示されます。
PDF 内のフォームや表も読めますか?
はい。表は行と列として返り、Excel に保存できます。フォームでは、各回答が対応する項目名と結びついたまま残ります。
無料で使えますか?
ウェブでは最初の10ページが無料で、書き出しも含まれます。さらに読み取るには、プランを選ぶかページを購入してください。アップロードした原本は、検討中も保存されます。
Inksight のほかの使い方。
どのツールも同じ OCR と同じドキュメントライブラリを使います。ここでスキャンしたページは、ログインすればどこからでも開けます。
あわせてどうぞ: Inksight とほかの OCR モデルの比較, 料金 と Android アプリ.